IDS Guía de estudio

Semana 5 · Módulo 6

Estructuras de datos lineales y algoritmos de ordenamiento

En la semana 3 tuviste que escribir dos veces la misma lista de ventas. Esta semana los datos se guardan en listas y tuplas, se buscan y se ordenan, y mides cuánto trabajo le cuesta a la computadora hacerlo.

Pregunta orientadora¿Cómo guardo, busco y ordeno cientos de registros en memoria, y cuánto cuesta hacerlo cuando los datos crecen?

Lecturas
PCC 3 · PCC 4 · BOU 4
Proyecto
Fase 3 (esta semana)
Evaluación
Control 2 (esta semana) · Parcial (semana 6)

Cómo usar esta guía

Antes de clasePCC 3 y 4 completos, BOU 4. Luego el checkpoint.
Durante el laboratorioImplementas Bubble e Insertion Sort sin sorted(): sigue el paso a paso y el laboratorio de desempeño.
Después de claseTrazas de ordenamiento a mano y ejercicios.
EvaluacionesControl 2 esta semana y el repaso integrador para el Parcial.
  • Pregunta
  • →
  • Exploración
  • →
  • Implementación
  • →
  • Resultado
  • →
  • Interpretación
  • →
  • Verificación

Qué puedes usar esta semana

Sí, desde ahora

  • Todo lo de las semanas 1 a 4
  • Listas: índices (también negativos), append, insert, pop, remove, del, len, in
  • sum, min, max; sort() y sorted() como herramienta (no en el laboratorio de algoritmos)
  • Slicing [inicio:fin:paso] y copia con [:]
  • list(range(...)) y listas por comprensión
  • Tuplas, inmutabilidad, desempaquetado
  • Pasar listas a funciones (retoma esa parte de PCC 8)
  • x += 1 como abreviatura de x = x + 1

Todavía no

  • Diccionarios y conjuntos → semana 7
  • Archivos CSV/JSON y try/except → semana 7
  • Clases → semana 8

Herramientas del laboratorio: random (generar datos de prueba) y time.perf_counter() (medir tiempo) se usan tal cual, sin profundizar.

Lecturas de preparación

Complementos gratuitos

Reading checkpoint

Con ventas = [120, 45, 300, 80], ¿qué es ventas[-1]?

Los índices negativos cuentan desde el final: -1 es el último. Los positivos empiezan en 0, así que ventas[4] sí da IndexError.

Con la misma lista, ¿qué devuelve ventas[1:3]?

Igual que range: incluye el inicio (1) y excluye el fin (3). Se toman los índices 1 y 2.

¿Qué imprime este código?

precios = [10, 20]
respaldo = precios
respaldo.append(30)
print(precios)

respaldo = precios no copia: crea un alias, un segundo nombre para la misma lista. Para copiar: respaldo = precios[:]. Este error ha arruinado más de un “respaldo” en la vida real.

¿Qué pasa al ejecutar producto = ("A01", "Aceite", 12.50) y luego producto[2] = 13.00?

Las tuplas son inmutables. Para “cambiar” el precio hay que crear una tupla nueva: producto = ("A01", "Aceite", 13.00). Útil para registros que no deben alterarse por accidente.

¿Cuál es la diferencia entre ventas.sort() y sorted(ventas)?

Error típico: ordenadas = ventas.sort() deja ordenadas en None.

Buscas un código en una lista desordenada de 1,000 productos con búsqueda lineal. En el peor caso, ¿cuántas comparaciones haces?

Peor caso: el producto está al final o no existe, y hay que revisar todos. El trabajo crece en proporción a n.

Después de la primera pasada de Bubble Sort (ascendente), ¿qué se puede garantizar?

Al comparar vecinos e intercambiar, el mayor “burbujea” hasta el final. Por eso cada pasada puede revisar un elemento menos.

¿Con qué datos Insertion Sort hace menos comparaciones?

Si ya está ordenada, cada elemento se compara una vez con su vecino y se queda donde está: n − 1 comparaciones. En orden inverso hace el máximo: n(n − 1)/2.

Con pedidos = ["A", "B", "C"], ¿qué hace x = pedidos.pop()?

pop() sin argumento quita y devuelve el último; pop(0), el primero. remove("B") quita por valor (la primera aparición) y no devuelve nada; del pedidos[1] quita por posición.

Listas y slicing

En palabras simples

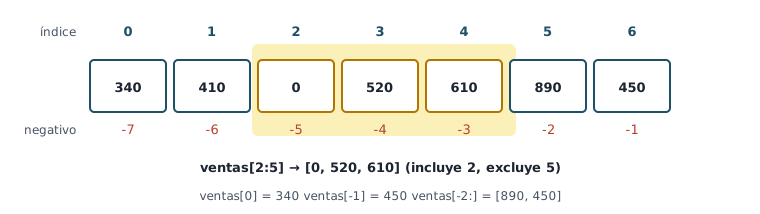
Una lista es una fila de casilleros numerados desde el 0. ventas[0] es el primer casillero y ventas[-1] el último. Un slice [2:5] es cortar una rebanada: desde el casillero 2 hasta antes del 5.

Caso: el registro de ventas de la semana

Pregunta

La Ceiba registra la venta de cada día. Se necesita: agregar el día nuevo, corregir un error de digitación, conocer total/promedio/mejor día y ver los últimos días, sin volver a escribir los datos.

Exploración

Una lista es una secuencia ordenada y modificable. Cada elemento tiene una posición (índice) que empieza en 0. Es el “rango de celdas” de Python.

Implementación
ventas = [340, 410, 0, 520, 610, 890]   # lunes a sábado

ventas.append(450)          # llega el domingo
ventas[2] = 380             # el miércoles se digitó 0 por error
print(f"Ventas: {ventas}")
print(f"Días: {len(ventas)}  Total: {sum(ventas)}  Promedio: {sum(ventas) / len(ventas):.2f}")

mejor = max(ventas)
dia_mejor = ventas.index(mejor) + 1     # +1 porque los índices empiezan en 0
print(f"Mejor día: {dia_mejor} (${mejor})")

print(f"Fin de semana: {ventas[-2:]}")
print(f"Primeros 3 días: {ventas[:3]}")
print(f"Días impares (1, 3, 5, 7): {ventas[::2]}")

sobre_500 = [v for v in ventas if v > 500]    # comprensión de lista
print(f"Días sobre $500: {sobre_500}")
Resultado
Ventas: [340, 410, 380, 520, 610, 890, 450]
Días: 7  Total: 3600  Promedio: 514.29
Mejor día: 6 ($890)
Fin de semana: [890, 450]
Primeros 3 días: [340, 410, 380]
Días impares (1, 3, 5, 7): [340, 380, 610, 450]
Días sobre $500: [520, 610, 890]
Interpretación

Compara con el E4 de la semana 3: aquello que requería contadores manuales y dos listas escritas ahora son funciones de una palabra. El dato corregido (miércoles) sube el promedio de $460 a $514.29: un error de digitación en un solo día cambiaba el diagnóstico de la semana.

Slicing, en resumen: lista[inicio:fin:paso], incluye inicio, excluye fin; cualquiera se puede omitir. [:] es una copia completa.

Lista de 7 ventas con índices positivos de 0 a 6 arriba y negativos de -7 a -1 abajo; el slice ventas[2:5] resaltado contiene 0, 520 y 610.
Índices positivos (desde 0) y negativos (desde −1 al final). El slice toma desde el inicio hasta antes del fin.
Verificación

340 + 410 + 380 + 520 + 610 + 890 + 450 = 3600 ✔; 3600 / 7 = 514.29 ✔. Y un caso borde que debes conocer: max([]) y sum([]) / len([]) fallan con una lista vacía. Valida if ventas: (una lista vacía es “falsa”) antes de calcular.

Alias vs. copia

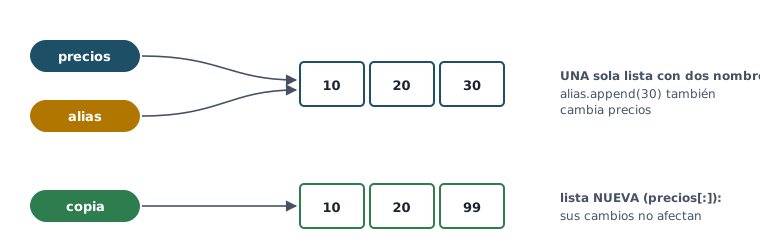
precios = [10, 20]
alias = precios          # MISMA lista, otro nombre
copia = precios[:]       # lista NUEVA con los mismos valores
alias.append(30)
copia.append(99)
print(precios, alias, copia)
[10, 20, 30] [10, 20, 30] [10, 20, 99]
precios y alias apuntan a la misma lista 10, 20, 30; copia apunta a una lista distinta 10, 20, 99.
= nunca copia una lista: le pone otro nombre. Para copiar, [:].
Listas dentro de funciones

Cuando pasas una lista a una función, la función recibe la misma lista (no una copia). Si la modifica, el cambio se ve afuera. Si una función solo debe leer o devolver un resultado nuevo, trabaja sobre lista[:]. PCC 8 lo explica en “Passing a List” y “Preventing a Function from Modifying a List”.

Tuplas: registros que no deben cambiar

En palabras simples

Una tupla es una lista sellada: se puede leer pero no cambiar. Sirve para registros que no deben alterarse por accidente, como un producto con su código, nombre y precio.

Una tupla es como una lista, pero inmutable y se escribe con paréntesis. Úsala para registros de campos fijos: un producto (código, nombre, precio), una coordenada, un par (base, IVA).

catalogo = [
    ("A01", "Aceite 1 L", 12.50),
    ("B07", "Arroz 5 lb", 4.25),
    ("C12", "Azúcar 5 lb", 3.90),
]

for codigo, nombre, precio in catalogo:        # desempaquetado en el for
    print(f"{codigo}  {nombre:<12} ${precio:>6.2f}")

codigo, nombre, precio = catalogo[1]           # desempaquetado directo
print(f"El segundo producto es {nombre}")
A01  Aceite 1 L   $ 12.50
B07  Arroz 5 lb   $  4.25
C12  Azúcar 5 lb  $  3.90
El segundo producto es Arroz 5 lb
Lista [ ]Tupla ( )
¿Se puede modificar?SíNo
Uso típicouna colección que crece o cambia (ventas del mes)un registro con campos fijos (un producto)
Métodosappend, remove, sort…solo count e index
Recuerdala tupla de un elemento lleva coma: ("A01",)

Ahora sabes qué devolvía desglosar_total en la semana 4: return base, iva construye la tupla (base, iva), y base, iva = ... la desempaqueta.

Búsqueda lineal

En palabras simples

Buscar sin orden es como buscar tu llave en un llavero revolviendo una por una: puedes tener suerte a la primera o tener que revisarlas todas. Por eso ordenar los datos ahorra tiempo después.

Caso: buscar un producto por código

Pregunta

El cajero escanea un código. ¿Está en el catálogo? ¿En qué posición? ¿Cuánto trabajo cuesta averiguarlo?

Exploración

Sin ningún orden en los datos, la única estrategia es revisar uno por uno desde el principio hasta encontrarlo o acabar. Devolvemos la posición, o -1 si no está (una convención común). Contamos comparaciones para medir el trabajo.

Implementación
def buscar_producto(catalogo, codigo_buscado):
    """Búsqueda lineal por código.

    Returns:
        (posicion, comparaciones); posicion es -1 si no se encontró.
    """
    comparaciones = 0
    for i in range(len(catalogo)):
        comparaciones += 1
        codigo = catalogo[i][0]           # primer campo de la tupla
        if codigo == codigo_buscado:
            return i, comparaciones       # se detiene al encontrarlo
    return -1, comparaciones


catalogo = [("A01", "Aceite", 12.50), ("B07", "Arroz", 4.25),
            ("C12", "Azúcar", 3.90), ("D03", "Café", 6.75)]

for codigo in ["A01", "D03", "Z99"]:
    posicion, comps = buscar_producto(catalogo, codigo)
    print(f"{codigo}: posición {posicion}, {comps} comparaciones")
Resultado
A01: posición 0, 1 comparaciones
D03: posición 3, 4 comparaciones
Z99: posición -1, 4 comparaciones
Interpretación

Mejor caso (primero de la lista): 1 comparación. Peor caso (último o inexistente): n comparaciones. Con 4 productos no importa; con 50,000 productos y 2,000 ventas al día, sí. Por eso importa ordenar: con datos ordenados existen búsquedas mucho más rápidas (búsqueda binaria), que verás en Estructuras de Datos.

Verificación

Prueba: el primero, el último, uno del medio, uno que no existe y una lista vacía (debe devolver (-1, 0) sin error). Compara con codigo in [p[0] for p in catalogo], la forma corta de Python, que por dentro también es búsqueda lineal.

Algoritmos de ordenamiento: Bubble Sort e Insertion Sort

En palabras simples

Bubble Sort: comparas vecinos y los intercambias; en cada pasada el más grande “sube” al final como una burbuja. Insertion Sort: como ordenar cartas en la mano; tomas la siguiente y la deslizas a la izquierda hasta su lugar.

En el laboratorio se implementan sin sort() ni sorted(). El objetivo no es reemplazarlos (Python ordena mucho más rápido), sino entender qué hace un algoritmo y cuánto trabajo le cuesta.

Bubble Sort: comparar vecinos e intercambiar

Pregunta

¿Cómo ordenar de menor a mayor los montos [42, 17, 58, 23, 9] usando solo comparaciones entre dos elementos vecinos?

Exploración (pseudocódigo)
REPETIR para cada pasada, mientras haya habido intercambios:
    PARA cada par de vecinos (j, j+1) en la parte aún no ordenada:
        SI datos[j] > datos[j+1] ENTONCES intercambiarlos
    (al final de la pasada, el mayor restante quedó en su lugar)
Implementación
"""Algoritmos de ordenamiento elementales con conteo de trabajo."""


def burbuja(lista):
    """Bubble Sort ascendente.

    Returns:
        (lista_ordenada, comparaciones, intercambios). No modifica la original.
    """
    datos = lista[:]                     # copia
    n = len(datos)
    comparaciones = 0
    intercambios = 0
    for pasada in range(n - 1):
        hubo_intercambio = False
        for j in range(n - 1 - pasada):  # los últimos 'pasada' ya están en su lugar
            comparaciones += 1
            if datos[j] > datos[j + 1]:
                datos[j], datos[j + 1] = datos[j + 1], datos[j]   # intercambio
                intercambios += 1
                hubo_intercambio = True
        if not hubo_intercambio:         # nada se movió: ya está ordenada
            break
    return datos, comparaciones, intercambios


def insercion(lista):
    """Insertion Sort ascendente.

    Returns:
        (lista_ordenada, comparaciones). No modifica la original.
    """
    datos = lista[:]
    comparaciones = 0
    for i in range(1, len(datos)):
        actual = datos[i]
        j = i - 1
        while j >= 0:
            comparaciones += 1
            if datos[j] > actual:
                datos[j + 1] = datos[j]  # desplaza el mayor una posición a la derecha
                j -= 1
            else:
                break
        datos[j + 1] = actual            # inserta en el hueco
    return datos, comparaciones
from ordenamiento import burbuja, insercion

montos = [42, 17, 58, 23, 9]
print(burbuja(montos))
print(insercion(montos))
print(montos)                      # la original sigue igual
Resultado
([9, 17, 23, 42, 58], 10, 7)
([9, 17, 23, 42, 58], 9)
[42, 17, 58, 23, 9]
Interpretación

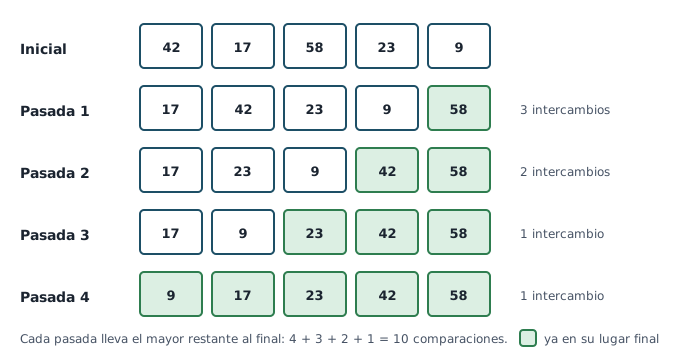
Bubble Sort hizo 4 pasadas con 4 + 3 + 2 + 1 = 10 comparaciones y 7 intercambios. La línea datos[j], datos[j + 1] = datos[j + 1], datos[j] intercambia dos valores gracias a las tuplas (sin variable temporal).

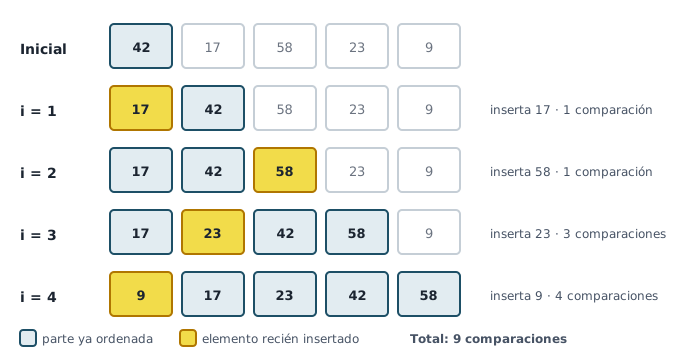
Insertion Sort funciona como ordenar facturas en la mano: tomas la siguiente y la deslizas hacia la izquierda hasta su lugar. Aquí hizo 9 comparaciones.

La bandera hubo_intercambio es una optimización: si una pasada no mueve nada, la lista ya está ordenada y se sale con break.

Bubble Sort sobre 42, 17, 58, 23, 9: después de cada pasada el mayor restante queda al final; tras 4 pasadas la lista queda 9, 17, 23, 42, 58.
Bubble Sort pasada por pasada (la misma lista de la traza 2).
Insertion Sort sobre 42, 17, 58, 23, 9: la parte izquierda ordenada crece de uno en uno y cada elemento se desliza hasta su lugar.
Insertion Sort elemento por elemento (traza 3).
Verificación
  • El resultado debe ser igual a sorted(montos): úsalo como “oráculo” en tus pruebas (aunque no en el algoritmo).
  • Casos borde: lista vacía, un elemento, dos elementos, todos iguales, valores repetidos, ya ordenada, en orden inverso.
  • La lista original no debe cambiar (por la copia lista[:]).

Laboratorio de desempeño algorítmico

En palabras simples

Si duplicas la cantidad de datos, estos algoritmos hacen cuatro veces el trabajo. Con 10 facturas no se nota; con 100,000, la diferencia es entre un segundo y varias horas.

Caso: ¿qué algoritmo conviene cuando los datos crecen?

Pregunta

Para 5 montos da igual. ¿Y para 100, 1,000 o 10,000 transacciones? ¿Y si los datos ya vienen casi ordenados (como un registro por fecha)?

Exploración

Dos formas de medir: contar comparaciones (no depende de la computadora, se puede razonar) y medir tiempo (depende de la máquina y varía entre ejecuciones). La primera es la que se defiende en un examen; la segunda confirma en la práctica.

Implementación: tres escenarios de 100 datos
import random

from ordenamiento import burbuja, insercion

N = 100
random.seed(2026)                                   # misma "aleatoriedad" en cada ejecución
ordenada = list(range(1, N + 1))
inversa = ordenada[::-1]
aleatoria = [random.randint(1, 1000) for _ in range(N)]

print(f"{'Escenario':<10} {'Bubble comp':>12} {'Bubble inter':>13} {'Insertion comp':>15}")
for nombre, datos in [("ordenada", ordenada), ("inversa", inversa), ("aleatoria", aleatoria)]:
    _, comp_b, inter_b = burbuja(datos)
    _, comp_i = insercion(datos)
    print(f"{nombre:<10} {comp_b:>12} {inter_b:>13} {comp_i:>15}")
Resultado
Escenario   Bubble comp  Bubble inter  Insertion comp
ordenada             99             0              99
inversa            4950          4950            4950
aleatoria          4779          2515            2612

Y midiendo tiempo con listas aleatorias de distinto tamaño:

import random
import time

from ordenamiento import burbuja, insercion

for n in [100, 1000, 3000]:
    datos = [random.randint(1, 100000) for _ in range(n)]
    inicio = time.perf_counter()
    burbuja(datos)
    t_burbuja = time.perf_counter() - inicio
    inicio = time.perf_counter()
    insercion(datos)
    t_insercion = time.perf_counter() - inicio
    print(f"n={n:>5}: burbuja {t_burbuja:.4f} s, inserción {t_insercion:.4f} s")
n=  100: burbuja 0.0004 s, inserción 0.0001 s
n= 1000: burbuja 0.0370 s, inserción 0.0149 s
n= 3000: burbuja 0.3805 s, inserción 0.1473 s
Interpretación
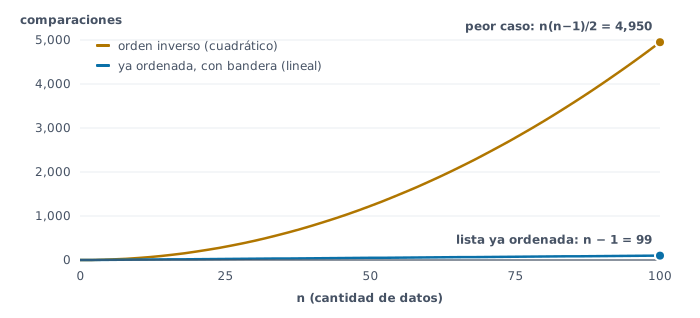
  • Peor caso (inversa): ambos hacen n(n − 1)/2 = 4,950 comparaciones. Duplicar n cuadruplica el trabajo: crecimiento cuadrático (se escribe O(n²)). Por eso de 1,000 a 3,000 datos el tiempo se multiplica por ~9, no por 3.
  • Datos ya ordenados: gracias a la bandera, Bubble Sort para tras una pasada (99 comparaciones); Insertion Sort también hace 99. Ambos se vuelven lineales.
  • Datos aleatorios: Insertion Sort hace aproximadamente la mitad de comparaciones que Bubble Sort, y muchos menos movimientos.
  • Decisión de negocio: para registros que llegan casi ordenados (por fecha), Insertion Sort es razonable. Para volúmenes grandes, ninguno de los dos: sorted() usa un algoritmo mucho más eficiente.
Comparaciones de Bubble e Insertion Sort según n: en el peor caso crecen como n por n menos 1 entre 2, llegando a 4950 con 100 datos; con la lista ya ordenada solo 99.
Mismo algoritmo, mismos 100 datos: el orden de entrada decide si hace 99 o 4,950 comparaciones.
Verificación

Los conteos del peor caso se pueden predecir sin ejecutar: (n − 1) + (n − 2) + … + 1 = n(n − 1)/2. Si tu contador da otra cosa en la lista inversa, tu implementación tiene un error. Esa es una prueba excelente para pytest.

Tablas de traza

Traza 1 · Índices y slicing

ventas = [340, 410, 0, 520, 610, 890, 450]. Escribe las listas con corchetes: [1, 2].

ExpresiónResultado
ventas[0]
ventas[-1]
ventas[2:5]
ventas[:3]
ventas[-2:]
ventas[1:-1]
len(ventas[::2])

Traza 2 · Bubble Sort pasada por pasada

Lista inicial [42, 17, 58, 23, 9]. Escribe el estado de la lista al final de cada pasada y cuántos intercambios hubo en ella.

PasadaComparacionesLista al finalIntercambios
1
2
3
4

Traza 3 · Insertion Sort elemento por elemento

Misma lista inicial. En cada fila se inserta el elemento indicado en la parte izquierda ya ordenada.

iSe insertaComparacionesLista después
1
2
3
4
¿Por qué insertar el 23 cuesta 3 comparaciones y el 58 solo 1?

El 58 se compara con 42, ve que 42 no es mayor y se queda. El 23 se compara con 58 (mayor, lo desplaza), con 42 (mayor, lo desplaza) y con 17 (no es mayor, se detiene): 3 comparaciones. Cuanto más lejos tiene que viajar un elemento, más cuesta.

Ejercicios

E1 · Cola de pedidos

métodos de listas · ★

Los pedidos llegan en orden y se despachan del más antiguo al más nuevo. Empieza con ["P-101", "P-102", "P-103"]. Simula: llega P-104; se despacha uno; llega P-105 marcado como urgente (debe ir al frente); el cliente de P-103 cancela; se despachan dos. Muestra la cola después de cada operación y la lista de despachados.

Solución
cola = ["P-101", "P-102", "P-103"]
despachados = []

cola.append("P-104")
print("Llega P-104:        ", cola)

despachados.append(cola.pop(0))          # el más antiguo está al inicio
print("Despacho:           ", cola)

cola.insert(0, "P-105")                  # urgente: al frente
print("Urgente P-105:      ", cola)

cola.remove("P-103")                     # cancelación por valor
print("Cancela P-103:      ", cola)

for _ in range(2):
    despachados.append(cola.pop(0))
print("Despacho x2:        ", cola)
print("Despachados:        ", despachados)
Llega P-104:         ['P-101', 'P-102', 'P-103', 'P-104']
Despacho:            ['P-102', 'P-103', 'P-104']
Urgente P-105:       ['P-105', 'P-102', 'P-103', 'P-104']
Cancela P-103:       ['P-105', 'P-102', 'P-104']
Despacho x2:         ['P-104']
Despachados:         ['P-101', 'P-105', 'P-102']

Casos borde: cola.pop(0) con la cola vacía lanza IndexError; remove de un pedido que no existe lanza ValueError. Valida con if cola: e if "P-103" in cola:. El _ en el for indica “no me importa el número de vuelta”.

E2 · Consultas al catálogo

tuplas + búsqueda · ★★

Con el catálogo de tuplas (codigo, nombre, precio, stock) de abajo, escribe funciones para: (a) buscar un producto por código y devolver la tupla completa o None; (b) devolver una lista con los productos cuyo stock está por debajo de un mínimo (para reordenar); (c) calcular el valor total del inventario (precio × stock).

catalogo = [
    ("A01", "Aceite 1 L", 12.50, 40),
    ("B07", "Arroz 5 lb", 4.25, 8),
    ("C12", "Azúcar 5 lb", 3.90, 0),
    ("D03", "Café 400 g", 6.75, 15),
]
Solución
catalogo = [
    ("A01", "Aceite 1 L", 12.50, 40),
    ("B07", "Arroz 5 lb", 4.25, 8),
    ("C12", "Azúcar 5 lb", 3.90, 0),
    ("D03", "Café 400 g", 6.75, 15),
]


def buscar(catalogo, codigo_buscado):
    """Devuelve la tupla del producto o None si no existe."""
    for producto in catalogo:
        if producto[0] == codigo_buscado:
            return producto
    return None


def por_reordenar(catalogo, minimo):
    """Lista de productos con stock menor que el mínimo."""
    return [p for p in catalogo if p[3] < minimo]


def valor_inventario(catalogo):
    """Suma de precio x stock de todos los productos."""
    total = 0
    for codigo, nombre, precio, stock in catalogo:
        total += precio * stock
    return round(total, 2)


print(buscar(catalogo, "D03"))
print(buscar(catalogo, "Z99"))
print([p[1] for p in por_reordenar(catalogo, 10)])
print(valor_inventario(catalogo))
('D03', 'Café 400 g', 6.75, 15)
None
['Arroz 5 lb', 'Azúcar 5 lb']
635.25

Verificación: 12.50×40 + 4.25×8 + 3.90×0 + 6.75×15 = 500 + 34 + 0 + 101.25 = 635.25 ✔. ¿El stock mínimo es “menor que” o “menor o igual”? Es una regla de negocio: decídela y pruébala en la frontera (stock = 10).

Nota de diseño: p[3] no dice qué es. En la semana 7 (diccionarios) y la 8 (clases) podrás escribir p["stock"] o p.stock. Ese es uno de los motivos de esas herramientas.

E3 · Ranking de vendedores (descendente)

ordenamiento propio · ★★

Adapta Insertion Sort para ordenar una lista de tuplas (vendedor, ventas) de mayor a menor por ventas, sin sort ni sorted. Muestra el top 3 con slicing. Datos: [("Ana", 3200), ("Luis", 4100), ("Marta", 2750), ("José", 4100), ("Eva", 3900)].

Pista

Solo cambian dos cosas: comparas el campo [1] de cada tupla, y la condición para desplazar es “el de la izquierda es menor”. ¿Qué pasa con Luis y José, que empatan?

Solución
def ordenar_por_ventas_desc(registros):
    """Insertion Sort descendente por el segundo campo de cada tupla."""
    datos = registros[:]
    for i in range(1, len(datos)):
        actual = datos[i]
        j = i - 1
        while j >= 0 and datos[j][1] < actual[1]:
            datos[j + 1] = datos[j]
            j -= 1
        datos[j + 1] = actual
    return datos


vendedores = [("Ana", 3200), ("Luis", 4100), ("Marta", 2750), ("José", 4100), ("Eva", 3900)]
ranking = ordenar_por_ventas_desc(vendedores)
top = ranking[:3]
for i in range(len(top)):
    nombre, ventas = top[i]
    print(f"{i + 1}. {nombre}: ${ventas:,}")

assert ranking == sorted(vendedores, key=lambda r: r[1], reverse=True)   # oráculo
1. Luis: $4,100
2. José: $4,100
3. Eva: $3,900

Empates: Luis queda antes que José porque ya estaba antes en la lista original y la condición usa < estricto (no desplaza iguales). Un algoritmo que respeta el orden original de los empates se llama estable. Si usaras <=, José pasaría delante. En un ranking comercial, ¿qué criterio de desempate es justo? Es una regla de negocio.

Verificación: la última línea compara con sorted usando key=lambda r: r[1] (“ordena por el segundo campo”). No necesitas dominar lambda todavía: aquí solo sirve de oráculo para comprobar tu algoritmo.

E4 · Pruebas para tus algoritmos

pytest · ★★

Escribe test_ordenamiento.py con pruebas para burbuja e insercion que cubran: lista vacía, un elemento, repetidos, ya ordenada (y cuántas comparaciones hace), orden inverso (debe hacer n(n − 1)/2 comparaciones), y que la lista original no se modifica.

Solución
from ordenamiento import burbuja, insercion


def test_lista_vacia():
    assert burbuja([])[0] == []
    assert insercion([])[0] == []


def test_un_elemento():
    assert burbuja([7])[0] == [7]


def test_repetidos():
    assert insercion([3, 1, 3, 2])[0] == [1, 2, 3, 3]


def test_ya_ordenada_una_sola_pasada():
    datos = list(range(10))
    assert burbuja(datos)[1] == 9          # n - 1 comparaciones
    assert insercion(datos)[1] == 9


def test_inversa_peor_caso():
    n = 20
    datos = list(range(n, 0, -1))
    assert burbuja(datos)[1] == n * (n - 1) // 2
    assert insercion(datos)[1] == n * (n - 1) // 2


def test_no_modifica_la_original():
    original = [5, 2, 9]
    burbuja(original)
    insercion(original)
    assert original == [5, 2, 9]


def test_coincide_con_sorted():
    datos = [42, 17, 58, 23, 9, 17]
    assert burbuja(datos)[0] == sorted(datos)
    assert insercion(datos)[0] == sorted(datos)

Sabotaje sugerido: quita - pasada del rango interno de burbuja: la lista sigue ordenándose bien, pero test_inversa_peor_caso falla porque hace comparaciones de más. Las pruebas de conteo vigilan la eficiencia, no solo el resultado.

E5 · Auditoría: tres errores con listas

auditoría · ★★★

Cada función tiene un error distinto. Para cada una: escribe una llamada que lo revele, explica la causa y corrígela.

def quitar_devoluciones(montos):
    """Devuelve la lista sin montos negativos."""
    for m in montos:
        if m < 0:
            montos.remove(m)
    return montos


def top_tres(ventas):
    """Devuelve las 3 ventas más altas sin alterar la lista original."""
    ordenadas = ventas
    ordenadas.sort(reverse=True)
    return ordenadas[:3]


def ordenar(lista):
    """Bubble Sort ascendente."""
    n = len(lista)
    for i in range(n):
        for j in range(n):
            if lista[j] > lista[j + 1]:
                lista[j], lista[j + 1] = lista[j + 1], lista[j]
    return lista
Pista

Prueba quitar_devoluciones([100, -20, -5, 300]); llama top_tres y luego imprime la lista que le pasaste; y ordenar([3, 1, 2]).

Solución
  1. quitar_devoluciones([100, -20, -5, 300]) devuelve [100, -5, 300]. Al borrar −20 mientras se recorre, los elementos se corren una posición y el bucle se “salta” el −5. Nunca modifiques una lista mientras la recorres; construye una nueva.
  2. top_tres desordena la lista original: ordenadas = ventas es un alias, así que sort() reordena la lista del que llamó, contradiciendo el docstring.
  3. ordenar([3, 1, 2]) lanza IndexError: cuando j = n - 1, lista[j + 1] se sale. El rango interno debe ser range(n - 1 - i). Además modifica la lista recibida.
def quitar_devoluciones(montos):
    """Devuelve una lista nueva sin montos negativos."""
    return [m for m in montos if m >= 0]


def top_tres(ventas):
    """Devuelve las 3 ventas más altas sin alterar la lista original."""
    return sorted(ventas, reverse=True)[:3]


def ordenar(lista):
    """Bubble Sort ascendente; devuelve una lista nueva."""
    datos = lista[:]
    n = len(datos)
    for i in range(n - 1):
        for j in range(n - 1 - i):
            if datos[j] > datos[j + 1]:
                datos[j], datos[j + 1] = datos[j + 1], datos[j]
    return datos


ventas = [340, 890, 120, 610]
assert quitar_devoluciones([100, -20, -5, 300]) == [100, 300]
assert top_tres(ventas) == [890, 610, 340]
assert ventas == [340, 890, 120, 610]       # la original quedó intacta
assert ordenar([3, 1, 2]) == [1, 2, 3]
print("Auditoría superada")
Auditoría superada

Lección: el error 1 no produce ningún mensaje y parece funcionar con [100, -20, 300]. Solo aparece con dos negativos seguidos: un caso borde que hay que buscar.

Práctica intensiva

Primero ejercicios rápidos con listas (se corrigen solos), luego problemas tipo examen. Son buena preparación para la parte práctica del Parcial.

Ejercicios rápidos · ¿Qué resulta?

Con v = [4, 8, 15, 16, 23, 42] cuando aparezca. Escribe las listas con corchetes y comas: [1, 2].

CódigoTu respuesta
v[2]
v[-2]
v[1:4]
v[::3]
len(v[2:])
a = [3, 1, 2]
a.append(5)
a.pop(0)
sorted([3, 1, 2], reverse=True)
[x * 2 for x in range(4)]
max([12, 7, 30]) - min([12, 7, 30])
v.index(16)

Problemas tipo examen

P1 · Totales y ranking por vendedor (sin diccionarios)

listas paralelas + ordenamiento propio · ★★★★

Tienes las ventas del día como tuplas (vendedor, monto), con vendedores repetidos. Calcula el total de cada uno usando dos listas paralelas (nombres y totales) y muestra un ranking descendente ordenado con tu propio Insertion Sort.

Tu programa debe cumplir estos casos de prueba:

DatoEsperado
Ana$350 (120 + 200 + 30)
Eva$150
Luis$120 (80 + 40)
Total general$620
Pista

Para cada venta: si el nombre ya está en nombres, busca su posición con index y suma en totales en esa misma posición; si no, agrégalo a ambas listas.

Solución
ventas = [("Ana", 120), ("Luis", 80), ("Ana", 200),
          ("Eva", 150), ("Luis", 40), ("Ana", 30)]

nombres = []          # listas paralelas: nombres[k] va con totales[k]
totales = []
for nombre, monto in ventas:
    if nombre in nombres:
        k = nombres.index(nombre)
        totales[k] += monto
    else:
        nombres.append(nombre)
        totales.append(monto)

# Ranking descendente con Insertion Sort sobre tuplas (nombre, total)
ranking = []
for k in range(len(nombres)):
    ranking.append((nombres[k], totales[k]))
for i in range(1, len(ranking)):
    actual = ranking[i]
    j = i - 1
    while j >= 0 and ranking[j][1] < actual[1]:
        ranking[j + 1] = ranking[j]
        j -= 1
    ranking[j + 1] = actual

for puesto in range(len(ranking)):
    nombre, total = ranking[puesto]
    print(f"{puesto + 1}. {nombre:<5} ${total:>4}")
print(f"Total general: ${sum(totales)}")
1. Ana   $ 350
2. Eva   $ 150
3. Luis  $ 120
Total general: $620

Por qué importa: mantener dos listas sincronizadas es frágil (si borras de una y no de la otra, todo se desalinea). En la semana 7 esto se resuelve en una línea con un diccionario. Entender el problema ahora te hará entender para qué sirve esa herramienta.

P2 · Mediana y percentil 90 de los tickets

ordenamiento + estadística · ★★★

El gerente quiere saber el ticket “típico” de la tienda. El promedio engaña si hay compras enormes. Calcula el promedio, la mediana (el valor del medio de los datos ordenados; si son pares, el promedio de los dos del medio) y el percentil 90 (el valor por debajo del cual está el 90 % de los tickets), usando tu propio ordenamiento.

Tu programa debe cumplir estos casos de prueba:

MedidaEsperado
Promedio$32.89
Mediana$22.40
Percentil 90$64.30
mediana([4, 1, 3, 2])2.5
Pista

Ordena primero. Con n impar, la mediana está en la posición n // 2. Para el percentil 90 usa la posición ⌈0.9 × n⌉ (contando desde 1).

Solución
tickets = [12.5, 48.0, 7.25, 30.0, 19.9, 105.0, 22.4, 15.0, 64.3, 9.8, 27.6]


def ordenar(datos):
    """Insertion Sort ascendente; devuelve una lista nueva."""
    d = datos[:]
    for i in range(1, len(d)):
        actual = d[i]
        j = i - 1
        while j >= 0 and d[j] > actual:
            d[j + 1] = d[j]
            j -= 1
        d[j + 1] = actual
    return d


def mediana(datos):
    d = ordenar(datos)
    n = len(d)
    if n % 2 == 1:
        return d[n // 2]
    return (d[n // 2 - 1] + d[n // 2]) / 2


def percentil_90(datos):
    """Método del rango más cercano: posición ceil(0.9 * n)."""
    d = ordenar(datos)
    k = (9 * len(d) + 9) // 10          # ceil(9n / 10) sin importar math
    return d[k - 1]


print(f"Promedio: ${sum(tickets) / len(tickets):.2f}")
print(f"Mediana:  ${mediana(tickets):.2f}")
print(f"P90:      ${percentil_90(tickets):.2f}")
assert mediana([3, 1, 2]) == 2
assert mediana([4, 1, 3, 2]) == 2.5
assert mediana(tickets) == sorted(tickets)[5]
Promedio: $32.89
Mediana:  $22.40
P90:      $64.30

Interpretación: el promedio ($32.89) es mayor que la mediana ($22.40) porque una compra de $105 lo arrastra hacia arriba. Para decidir promociones, la mediana describe mejor al cliente típico.

P3 · Unir los cierres de dos cajas ya ordenados

algoritmo de intercalación · ★★★★

Dos cajas entregan sus montos del día ya ordenados. Únelos en una sola lista ordenada recorriendo cada lista una sola vez (sin volver a ordenar todo). Cuenta las comparaciones.

Tu programa debe cumplir estos casos de prueba:

Qué comprobarEsperado
Resultado[5.0, 8.5, 12.0, 12.0, 19.99, 22.0, 30.0, 41.25, 90.0]
Comparaciones8 (menos que n)
Una lista vacíadevuelve la otra tal cual
Pista

Usa dos índices, uno por lista. En cada paso compara los dos “frentes” y pasa el menor al resultado. Cuando una lista se acaba, copia el resto de la otra.

Solución
caja_1 = [8.5, 12.0, 30.0, 41.25]          # montos ya ordenados
caja_2 = [5.0, 12.0, 19.99, 22.0, 90.0]


def intercalar(a, b):
    """Une dos listas ordenadas en una sola ordenada, recorriendo cada una una vez."""
    resultado = []
    i = 0
    j = 0
    comparaciones = 0
    while i < len(a) and j < len(b):
        comparaciones += 1
        if a[i] <= b[j]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])                   # lo que quede de a
    resultado.extend(b[j:])                   # lo que quede de b
    return resultado, comparaciones


unidos, comps = intercalar(caja_1, caja_2)
print(unidos)
print(f"{comps} comparaciones para {len(unidos)} montos")
assert unidos == sorted(caja_1 + caja_2)
assert intercalar([], [1, 2])[0] == [1, 2]
[5.0, 8.5, 12.0, 12.0, 19.99, 22.0, 30.0, 41.25, 90.0]
8 comparaciones para 9 montos

Por qué es fuerte: juntar y reordenar con Insertion Sort costaría hasta n(n − 1)/2 = 36 comparaciones; intercalar costó 8. Esta idea es el corazón de Merge Sort, uno de los algoritmos que verás en Estructuras de Datos.

Proyecto integrador · Fase 3

Semana 5 · Prototipo funcional y colecciones.

Entregables de esta fase

Qué viene Fase 4 (semana 7): persistencia en archivos JSON/CSV y manejo de excepciones. Fase 5 (semana 9): refactorización a clases y 5 pruebas automáticas. Diseñen las funciones de hoy pensando en que mañana los datos vendrán de un archivo.

Preguntas de defensa

¿Por qué usan una lista aquí y una tupla allá?

Lista para colecciones que cambian (se agregan ventas); tupla para registros de campos fijos que no deben modificarse por accidente (un producto con código, nombre y precio).

¿Qué algoritmo de ordenamiento usaron y cuántas comparaciones hace en el peor caso?

Nombra el algoritmo, da la fórmula n(n − 1)/2 para el peor caso de Bubble/Insertion, y explica cuándo conviene (datos casi ordenados) y cuándo no (volúmenes grandes: sorted()).

¿Qué pasa si su búsqueda no encuentra el elemento?

Debe devolver una señal clara (None o -1), y quien la llama debe manejarla antes de usar el resultado. Muestra el caso de prueba que lo comprueba.

¿Alguna función modifica la lista que recibe? ¿Es intencional?

Explica si trabaja sobre una copia ([:]) o sobre la original, y por qué. Un efecto secundario no documentado es un error aunque “funcione”.

¿Cómo crece el tiempo de su sistema si los datos se multiplican por 10?

Si hay una búsqueda lineal dentro de un bucle sobre los mismos datos, el trabajo crece como n²: 10× datos = ~100× trabajo. Identifica esos puntos en tu código.

Control 2 y Examen Parcial

Control 2 esta semana y Examen Parcial teórico-práctico en la semana 6 (individual, presencial en laboratorio, sin IA). El temario exacto lo confirma el docente en Moodle; lo razonable es que el Parcial integre las semanas 1 a 5.

De esta semana, asegúrate de poder:

Repaso integrador para el Parcial (semanas 1–5)

Preguntas que mezclan temas, como en un examen. Si fallas una, vuelve a la semana indicada.

¿Qué imprime? (S2 + S3)

total = 0
for n in range(1, 10, 3):
    if n % 2 == 0:
        continue
    total += n
print(total)

range(1, 10, 3) → 1, 4, 7. El 4 es par y se salta. 1 + 7 = 8.

¿Qué devuelve f([5, 3, 8])? (S4 + S5)

def f(datos):
    mayor = datos[0]
    for d in datos[1:]:
        if d > mayor:
            mayor = d
    print(mayor)

Pregunta trampa típica: “¿qué devuelve?” vs “¿qué imprime?”. Sin return, devuelve None.

Con precio = 50, ¿qué rama se ejecuta? (S2)

if precio > 50:
    categoria = "alta"
elif precio >= 20:
    categoria = "media"
else:
    categoria = "baja"

50 > 50 es falso; 50 >= 20 es verdadero. Las fronteras son el lugar favorito de los exámenes.

¿Cuál es el error de este bucle? (S3)

saldo = 1000
while saldo > 0:
    pago = 200
saldo = saldo - pago

La indentación define qué está dentro del bucle. Dentro solo se asigna pago, así que saldo nunca cambia.

¿Qué muestra git status justo después de git add informe.py (archivo nuevo)? (S1)

add lo pasa al área de preparación. Solo después de commit queda en el historial, y solo después de push en GitHub.

¿Cuántas comparaciones hace Bubble Sort (con la bandera de salida temprana) sobre [1, 2, 3, 4, 5, 6]? (S5)

Una pasada completa (n − 1 = 5 comparaciones) sin intercambios, y la bandera termina el algoritmo. Sin la bandera haría 15.

¿Qué vale x? (S4 + S5)

def agregar_iva(precios):
    for i in range(len(precios)):
        precios[i] = round(precios[i] * 1.13, 2)

x = [10, 20]
agregar_iva(x)

La función recibe la misma lista y la modifica en su lugar. A diferencia de reasignar una variable numérica (semana 4), mutar una lista sí se ve afuera.

Repasa también las listas “puedo…” de las semanas 1, 2, 3 y 4.

Fuentes

  • [PCC] Matthes, E. (2023). Python Crash Course, 3.ª ed. Caps. 3 y 4 (y cap. 8, secciones sobre listas).
  • [BOU] Bouna, P. (2022). Fundamentals of Programming Using Flowchart and Pseudocode. Cap. 4.
  • Python Software Foundation. Tutorial — Estructuras de datos · HOWTO — Ordenar.